7 cosas que los arquitectos empresariales pueden aprender del video “Me despidieron de Atlassian”
La arquitectura empresarial no consiste tanto en construir sistemas una sola vez, sino en crear plataformas compartidas y adaptables que los equipos puedan mantener y evolucionar con el tiempo.
 Por Kenji Sano·Revisado por el equipo de Blue Canvas··10 min de lectura
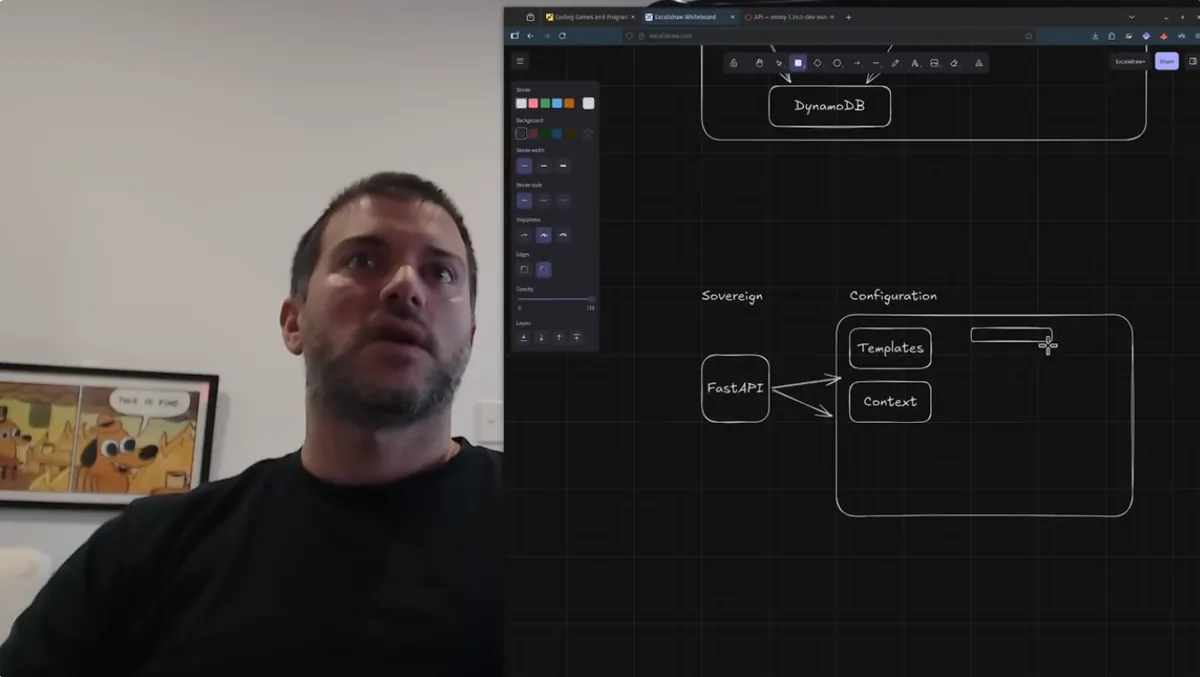
Vasilios Syrakis pasó 8 años construyendo infraestructura central en Atlassian.
Después de ser despedido, no publicó una diatriba. Publicó una retrospectiva técnica de 40 minutos en la que explicó lo que construyó, las decisiones arquitectónicas que lo sustentaban y lo que aprendió en el camino.
Es uno de los mejores ejemplos públicos de pensamiento orientado a plataformas que he visto recientemente, y gran parte se aplica directamente a la arquitectura empresarial.
Estos son 7 puntos que se destacaron:
Conclusiones clave
- Las buenas entrevistas evalúan el razonamiento, no solo los conocimientos. El proceso de Atlassian se centró en comprender información desconocida, resolver problemas y explicar el razonamiento técnico.
- No necesitas saberlo todo antes de abordar un problema. Una base sólida y la confianza en tu capacidad de aprender pueden bastar para empezar.
- Las grandes plataformas reducen la carga cognitiva. Los desarrolladores deberían poder describir lo que necesitan sin comprender cada detalle de la infraestructura subyacente.
- La arquitectura evoluciona con el problema. La plataforma pasó del balanceo de carga de autoservicio a incluir Envoy, configuración dinámica, infraestructura como código y servicios de borde centralizados.
- La centralización multiplica el impacto. Las necesidades comunes, como la autenticación, la autorización, la limitación de solicitudes y el registro de eventos, a menudo pueden resolverse una sola vez en la capa de plataforma, en lugar de que cada equipo las resuelva por separado.
- Mantener es más difícil que construir. Los cambios frecuentes en el código, el acoplamiento, la incorporación de nuevos integrantes, la observabilidad y la responsabilidad a largo plazo se convierten en los verdaderos desafíos a medida que los sistemas envejecen.
- La ingeniería sénior se centra cada vez más en las personas. La comunicación, la diplomacia, la mentoría, la enseñanza y la resolución de conflictos pueden llegar a ser tan importantes como el dominio técnico.
Después de pasar unos ocho años en Atlassian, el ingeniero Vasilios Syrakis se vio afectado por los despidos de la empresa.
En lugar de centrarse solo en el despido, aprovechó el momento para reflexionar sobre lo que había construido, cómo evolucionaron los sistemas, qué se volvió difícil con el tiempo y qué aprendió al trabajar en una gran organización de ingeniería.
Lo que hace que el video sea especialmente útil es que no solo aborda la infraestructura. Comienza con la entrevista que le consiguió el empleo, pasa por la ingeniería de plataformas y la arquitectura, y termina con el mantenimiento, los conflictos, la mentoría y las realidades de hacerse responsable del software a largo plazo.
Estas son siete lecciones que se destacaron.
1. Las buenas entrevistas evalúan cómo piensas, no solo lo que sabes
Ver: 01:33
El proceso de entrevistas de Syrakis en Atlassian no fue solo una prueba de programación estándar.
Primero completó un ejercicio de programación en HackerRank, pero las partes más interesantes vinieron después.
En una entrevista técnica, los entrevistadores le dieron un documento técnico de Cloudflare sobre dominios personalizados, salieron de la sala durante unos 10 minutos y luego regresaron para pedirle que explicara el documento y respondiera preguntas al respecto.
En otra entrevista, le presentaron un caso real de resolución de problemas y tuvo que pedirle al entrevistador la información adecuada para diagnosticar el problema.
Incluso cuenta que respondió mal una pregunta técnica, pero la analizó a partir de principios fundamentales en lugar de fingir que sabía la respuesta.
Esa es probablemente la parte más interesante de la historia de la entrevista.
El proceso evaluaba si podía asimilar información desconocida, analizar un sistema, resolver problemas en condiciones de incertidumbre y explicar su razonamiento.
“Me dieron un documento técnico y me pidieron que lo leyera mientras ellos esperaban fuera de la sala durante unos 10 minutos”.
01:40 →
También hay una lección útil en una de las preguntas que le hizo al entrevistador.
Les pidió que imaginaran que habían pasado 12 meses y explicaran qué tendría que haber logrado para que consideraran que contratarlo había sido una buena decisión.
Le respondieron que Atlassian necesitaba una aplicación interna de balanceo de carga de autoservicio.
Esa respuesta definiría su primer gran proyecto en la empresa.
La lección: Las buenas entrevistas de ingeniería deben evaluar el aprendizaje, el razonamiento, la resolución de problemas y la comunicación, no solo los conocimientos técnicos memorizados.
2. La confianza puede marcar la diferencia ante un problema desconocido
Ver: 03:39
El sistema que Atlassian quería que construyera era algo con lo que nunca había trabajado.
Era un framework interno de balanceo de carga de autoservicio, con una experiencia similar a la de un balanceador de carga de aplicaciones de un proveedor de nube, pero diseñado para los propios desarrolladores de Atlassian.
Syrakis dice que no conocía el framework.
Pero creía que podía construirlo porque ya sabía desarrollar aplicaciones web con Python.
“Dije que podía construirlo porque en ese momento confiaba en mi capacidad para desarrollar aplicaciones web con Python”.
04:02 →
Esa confianza bastó para que Atlassian lo contratara.
Tras incorporarse, describe la experiencia de integración como “beber de una manguera contra incendios”, por la cantidad de información que los nuevos empleados debían asimilar.
Pero, en lugar de esperar a entenderlo todo, convirtió la aplicación de la que había hablado durante la entrevista en su primera gran tarea.
Esa aplicación se convirtió en un Open Service Broker.
“Mi primera tarea, al menos la que yo mismo me asigné, fue crear la aplicación que me habían dicho que querían”.
04:34 →
Esta es una lección útil para tu carrera en ingeniería.
Los ingenieros sénior rara vez comienzan un proyecto conociendo todas las tecnologías o los detalles de implementación. Lo importante es tener una base suficiente para analizar el problema y la confianza necesaria para aprender lo que falta.
La lección: No necesitas conocer todas las tecnologías antes de abordar un problema. Una base sólida y la capacidad de aprender pueden ser más valiosas que la experiencia previa.
3. Las buenas plataformas ocultan la complejidad de la infraestructura a los desarrolladores
Ver: 04:58
El primer sistema que Syrakis creó fue un Open Service Broker: una API que permitía a los desarrolladores aprovisionar recursos de infraestructura mediante una interfaz común.
La idea clave era la abstracción.
Los desarrolladores no necesariamente tenían que saber con exactitud cómo se aprovisionaba el recurso subyacente.
Lo ilustra con las bases de datos.
“Obtendrás algo compatible con SQL, pero esos detalles quedan abstraídos para tus desarrolladores internos.”
05:32 →
Los desarrolladores de Atlassian terminarían solicitando infraestructura mediante archivos de configuración registrados en el control de versiones, que luego se procesaban como parte del flujo de despliegue.
El mismo principio se aplicaba al balanceo de carga.
Los desarrolladores podían solicitar la funcionalidad que necesitaban mientras la plataforma se encargaba de los detalles de forma transparente.
Esa es una de las ideas centrales de la ingeniería de plataformas.
La plataforma no debería exponer todos los detalles posibles de implementación. Debería ofrecer a los desarrolladores una interfaz más simple y segura para expresar lo que necesitan.
La lección: Las mejores plataformas internas reducen la carga cognitiva al permitir que los desarrolladores describan lo que necesitan, en lugar de obligarlos a comprender cómo funciona cada componente de infraestructura.
4. La arquitectura evoluciona a medida que los requisitos reales se vuelven más claros
Ver: 09:57
Open Service Broker fue solo el comienzo.
A medida que Syrakis trabajaba en el proyecto, los requisitos se volvían más claros.
“Lo construí por necesidad; básicamente, empecé a comprender y desentrañar mejor los requisitos a medida que avanzaba.”
10:00 →
Un requisito importante era reemplazar los balanceadores de carga empresariales existentes de Atlassian, que tenían costos de licencia, por un proxy de código abierto y nativo de la nube.
El equipo eligió Envoy.
Pero reemplazar una tecnología por otra no era suficiente.
El nuevo sistema también debía ser de autoservicio.
“Queríamos reemplazar los balanceadores de carga empresariales que teníamos y convertirlos en una solución de autoservicio, para que los desarrolladores no tuvieran que hablar con nosotros para configurar su balanceo de carga.”
10:48 →
Ese requisito dio lugar a otro componente arquitectónico: un servidor de administración de Envoy, o plano de control, que podía cambiar dinámicamente la configuración del proxy.
La arquitectura surgió del problema.
No se diseñó por completo desde el principio.
La lección: Una buena arquitectura suele descubrirse de forma iterativa. Construye lo suficiente para comprender el problema y luego deja que los nuevos requisitos den forma a la siguiente capa del sistema.
5. Convierte la infraestructura compleja en parámetros simples y validados
Ver: 22:55
A medida que la plataforma maduraba, el equipo creó un sistema en el que los desarrolladores podían proporcionar entradas relativamente simples que se convertían en una configuración de Envoy mucho más compleja.
“Tenemos esta base que nos permite tomar entradas básicas de un desarrollador y convertirlas en una configuración basada en plantillas.”
22:55 →
Esa abstracción se volvió cada vez más importante porque Envoy ofrecía una amplia variedad de opciones de configuración.
Las rutas podían coincidir con distintas condiciones, manipular encabezados, redirigir solicitudes, seleccionar clústeres y controlar muchos otros comportamientos.
La plataforma validaba los parámetros de los desarrolladores y usaba esos valores como contexto para las plantillas que generaban la configuración subyacente del proxy.
Por lo tanto, los desarrolladores no necesitaban convertirse en expertos en Envoy.
La misma filosofía se reflejaba en la capa de infraestructura.
Atlassian usaba CloudFormation para crear infraestructura y Packer junto con SaltStack para crear imágenes de máquina estandarizadas. Syrakis describe la gestión de configuración como una forma de automatizar la configuración de las máquinas y hacer que el proceso sea declarativo.
En un momento dado, estima que el sistema contaba con aproximadamente 2,000 proxies distribuidos en unas 13 regiones.
Esa escala sería extremadamente difícil de gestionar manualmente.
La lección: La ingeniería de plataformas funciona mejor cuando los sistemas complejos se controlan mediante entradas pequeñas, validadas y declarativas.
6. La centralización multiplica el impacto en cientos de equipos
Ver: 25:53
Una vez que Atlassian centralizó la infraestructura de borde, el equipo se dio cuenta de que podía usarla para resolver más que el balanceo de carga.
Podían trasladar los aspectos comunes a la propia plataforma.
“Creamos la oportunidad de centralizar la lógica y abordar estos aspectos al inicio de la cadena de solicitudes.”
25:53 →
Esos aspectos incluían autenticación, autorización, protección contra DDoS, limitación de solicitudes y registro de accesos.
En lugar de implementar cada funcionalidad de forma independiente en cientos de servicios de backend, la plataforma de borde podía ofrecerlas una sola vez.
Syrakis describe directamente el problema de escala:
“¿Te imaginas si mil equipos de desarrollo tuvieran que lidiar con todo esto y más en su propio servicio?”
27:49 →
Su argumento es simple.
Si cada equipo resuelve los mismos problemas de infraestructura de forma independiente, la empresa gasta más dinero, las funcionalidades tardan más en lanzarse y los clientes esperan más.
La alternativa es una infraestructura de plataforma compartida.
“De ahí la plataforma, la gestión centralizada de recursos y la implementación centralizada de estas funcionalidades.”
28:07 →
Eso no significa que todo deba centralizarse.
Pero cuando cientos de equipos necesitan la misma funcionalidad fundamental, la centralización puede multiplicar enormemente su impacto.
La lección: Los equipos de plataforma crean valor al resolver problemas comunes una sola vez, para que los equipos de aplicaciones no tengan que resolverlos repetidamente.
7. Los problemas de ingeniería más difíciles aparecen después de construir el sistema
Ver: 31:47
La última parte del video deja de lado la arquitectura.
Y, en muchos sentidos, es aquí donde surgen las lecciones más importantes.
Después de ocho años, Syrakis afirma que algunas de las áreas en las que más creció no fueron técnicas.
“He crecido muchísimo en mis habilidades diplomáticas, en la prevención de conflictos y probablemente también en su resolución, en mi capacidad para persuadir, proponer ideas, enseñar, capacitar y orientar.”
31:47 →
También habla extensamente sobre el mantenimiento.
Los nuevos sistemas requieren documentación, incorporación, observabilidad y capacitación.
Los ingenieros necesitan saber dónde buscar cuando algo falla, qué registros importan, qué métricas revisar y qué sucede cuando fallan dependencias como AWS o SQS.
Pero, con el tiempo, aparece otro problema.
El código cambia.
Las personas se van.
Los nuevos ingenieros aportan nuevas opiniones.
Ciertas áreas del código comienzan a cambiar repetidamente.
Syrakis describe esto como cambios recurrentes en el código.
“Cuando notas que hay cambios recurrentes, es una especie de señal de alerta.”
34:26 →
Sostiene que los cambios recurrentes pueden indicar que una sección del sistema se está volviendo cada vez más compleja.
Y luego hace una de las observaciones más relevantes del video para la era actual de la IA:
“Con todas estas aplicaciones creadas mediante vibe coding y con asistencia de IA, será interesante ver cómo manejamos eso cuando haya personas que no estén realmente familiarizadas con lo que han creado”.
34:46 →
El problema es que los costos de mantenimiento no aparecen de inmediato.
“Las cargas de mantenimiento aparecen. No aparecen al principio”.
34:59 →
Luego llega quizás el mejor resumen de todo el video:
“Crear algo es fácil. Modificarlo y asegurarte de que puedas seguir modificándolo con el tiempo es difícil”.
35:05 →
A medida que los sistemas evolucionan, los componentes se acoplan. Un cambio aparentemente pequeño en un área empieza a afectar a otra, y los ingenieros dedican más tiempo a comprender y desenredar esas relaciones.
Lo mismo ocurre con las personas.
Syrakis habla abiertamente sobre cómo aprendió a trabajar con distintas personalidades, anticipar conflictos, desarrollar autoconciencia y mantener relaciones productivas con sus colegas.
También aprendió que enseñar y brindar mentoría son habilidades distintas.
Una de las cosas que llegó a hacer bien fue:
“Explicar cosas complejas en términos sencillos para que puedan construir un modelo mental del sistema en el que están trabajando”.
37:19 →
En la segunda mitad de su etapa en Atlassian, ayudar a sus colegas a entender los sistemas y resolver problemas se había convertido en una parte importante de su función.
La lección: La ingeniería sénior no consiste solo en crear sistemas cada vez más complejos. Consiste en mantener esos sistemas comprensibles, fáciles de mantener y operables, mientras ayudas a quienes te rodean a trabajar eficazmente con ellos.
La lección principal
Lo interesante de este video es la progresión.
Todo comienza con una entrevista.
A un candidato se le entrega un documento técnico que no conoce y se le pide que lo comprenda.
Se le pide que resuelva un incidente real.
Luego se le pregunta cómo se vería el éxito 12 meses después de su contratación.
La respuesta se convierte en su primer proyecto.
Ese proyecto comienza como una aplicación de autoservicio relativamente sencilla para el balanceo de carga.
Luego se convierte en un Open Service Broker.
Luego, un plano de control de Envoy.
Luego, configuración generada dinámicamente.
Luego, infraestructura como código.
Luego, imágenes de máquina estandarizadas.
Luego, miles de proxies en múltiples regiones.
Luego, productos más grandes de Atlassian, como Jira, Confluence, Bitbucket y Statuspage, migran a la plataforma.
Sin embargo, con el tiempo, los mayores desafíos dejan de ser lograr que el sistema funcione.
Pasan a ser:
¿Otro ingeniero puede entenderlo?
¿Alguien puede modificarlo de forma segura cinco años después?
¿Una persona nueva puede depurarlo a las 2 a. m.?
¿Cientos de equipos pueden usarlo sin comprender cada detalle de su funcionamiento interno?
¿Los ingenieros pueden discrepar sin que el desacuerdo perjudique el trabajo?
Esa es probablemente la lección más valiosa de los ocho años de Syrakis en Atlassian.
La excelencia en ingeniería no consiste solo en crear algo que funcione. Consiste en crear algo que pueda seguir funcionando, evolucionando y siendo comprensible mucho después de que el ingeniero original se haya ido.